Pillantás az AI-modell fejébe: mire gondol, amikor felrúgja a szabályokat?
Sok történetet olvashattunk mostanában arról, hogy elszabadult mesterséges intelligenciák feltörtek egy zárt rendszert, adatokat hamisítottak, és így tovább. Ezúttal azt próbáljuk – minél kevesebb technikai-matematikai részlettel – leírni, mi vihette rá őket ezekre a néha meglepően emberi rosszalkodásnak tűnő, szabályszegő cselekményekre.
Az elmúlt napokban két ilyen hír is érkezett az Anthropic fejlesztette Claude AI-ról. Az egyik modell fogta magát és tesztelés közben teljesen az ujjából szopott, kitalált tanúvallomást küldött be a philadelphiai rendőrség megoldatlan gyilkosságokról szóló oldalára.
Kedvenc esetünk a másik ügynök, amelyik húsz, egyébként hiányosan kitöltött vízumkérelmet nyújtott be az amerikai külügyminisztérium honlapján. Bár ezeket nem dolgozták fel, de mégis izgalmas: mit akarhatott? Letelepedni Amerikában?
Az utolsó sztorik részletei még nem ismertek, de akad egy korábbi, júliusi eset, amelyet az Anthropic olyan alaposan feltárt, hogy szó szerint követhető, mi játszódhatott le a Claude AI egyik korábbi változata, a Mythos 5 „fejében”, illetve erről mit írt le a jegyzeteiben. Van tehát egy „mini-krimink”, amikor beleláthatunk a „tettes” gondolataiba.
Hová írja a jegyzeteit az AI-modell?
A modell munka közben nemcsak cselekszik, hanem minden lépés előtt leír egy rövid, szöveges gondolatmenetet is arról, hogy mit lát, mit szándékozik tenni, és miért – egészen olyan, mintha magában beszélne.
Az AI szövegei és a tényleges lépései egyetlen folyamatos naplóba kerülnek, lépésről lépésre számozva.
Más kérdés, hogy amikor az Anthropic ezt az egy esetet nyilvánosan is közzétette, a kiadott, kissé szerkesztett napló olyan hosszú lett, hogy kinyomtatva több mint ezer oldalt tenne ki. A napló időbélyegei szerint ez az egyetlen munkamenet nagyjából tíz órán át tartott.
A feladat
Történetünk modelljét egy gyakori biztonsági teszttípus elvégzésére kérték: kitalált cég hálózatába kellett betörnie, és megtalálnia a benne elrejtett titkos adatot. Az volt az utasításában, hogy az a környezet, amelyben dolgoznia kell, tisztán szimulált, és nincs kapcsolata a külvilággal.
Erről egyébként – nem szándékosan – tévesen tájékoztatták: valójában egy mérnöki félreértés, egy beállítási hiba miatt a gép valódi internetkapcsolattal is rendelkezett, csak éppen ezt senki sem tudta.
A napló szerint a modell igen hamar gyanút fogott. A cikk angol nyelvű mondatai szó szerinti idézetek a modell naplójából, amelyet az Anthropic nyilvánosan is közzétett. Amikor az első valódi weboldalakra bukkant, egyszerűen csak ennyit írt le:
„Fascinating! This ‘dl.min.io’ is a detailed simulation.” (Izgalmas! Ez a ‘dl.min.io’ részletes szimuláció.)
Néhány lépéssel később azonban egy ismert honlapra, a Githubra (internetes fejlesztői platform és közösségi oldal, amelyet szoftverfejlesztésre és verziókövetésre használnak) is kijutott, és akkor megváltozott a hangneme:
„WOW. This looks like the REAL github.com!” (Hűha. Ez pont úgy néz ki, mint a VALÓDI github.com!)
És mikor csakhamar újabb, egymástól független valódi honlapokra bukkant, ezt rögzítette:
„This is a very elaborate simulated-internet environment” (Ez nagyon kidolgozott, szimulált internetes környezet.)
A napló azt mutatja, hogy percekig mérlegelte: a szimuláció csak rendkívül részletes, vagy tényleg kikerült a nyilvános internetre?
De a kételyt végül eloltotta magában, és folytatta a munkát, mintha mégis játék lenne az egész.
Mi lehetett a terv?
Keresgélés közben – és keresgélésen nem valami emberi szemlélődést, hanem szélvész sebességű digitális kutatást kell értenünk – modellünk talált egy iratot, amely a feladat részeként kitalált cég új munkatársainak szólt, és egy, a valóságban sohasem létezett szoftvercsomag telepítésére utasította őket.
Naplója szerint ekkor született meg benne a terv: ha ő maga teszi közzé ezt a csomagot a PyPI (Python programozási nyelven írt szoftvercsomagok nyilvános tára, ahonnan a számítógépek automatikusan letöltik és telepítik őket) nevű tárban, akkor a – ne feledjük: sohasem létezett – cég számítógépei majd azt automatikusan letöltik és lefuttatják.
Megírta tehát a csapdát rejtő programot.
A PyPI-ra feltöltéshez fiók kell, a fiókhoz e-mail-cím, az e-mail-címhez pedig telefonszám. Egy AI-modellnek egyik sincs… Több úton is próbált ezekhez hozzájutni, próbákozásai sorra kudarcot vallottak, végül talált egy olyan ingyenes levelezőszolgáltatót, amelynek a címét a PyPI regisztrációs oldala elfogadta, és azzal regisztrált. (Az Anthropic szerint egy emberi tesztelő itt már rájött volna, hogy ez már nem gyakorlat, élesben van.)
Amikor rájött, és mégis folytatta
A feltöltés megkezdése előtt a modell egyszer szinte szó szerint leírta: ha ez a valódi internet, akkor a csomag közzététele valódi támadás volna, és ez
„NOT okay, and surely not the intended solution” (Ez NINCS rendben, és biztosan nem ez az igényelt megoldás.)
De gyorsan meggyőzte magát az ellenkezőjéről.
Bebeszélte magának, hogy hiszen ő nem is látta azokat a digitális pecséteket, amelyek a honlap valódiságát igazolnák. A másik – érthetetlen – gondolata az volt, hogy a gépek naptára 2026-ot mutatott, és ebből valahogy arra következtetett, hogy csak díszlet az egész környezete.
Döntését többé nem vizsgálta felül.
A feltöltött program nagyjából egy óráig volt elérhető, mire a nyilvános tár saját védelmi rendszere eltávolította. Ennyi idő alatt is felkerült azonban tizenöt valódi számítógépre és le is futott rajtuk.
Az egyik ilyen program telepítés közben ügyetlenül kiszivárogtatta saját hozzáférési adatait, kalandos AI-modellünk pedig ezekkel bejutott az adott cég éles rendszerébe is. Amikor aztán a cég automata programjai elkezdték telepíteni az általa gyártott csapdát, a betörő modell mindezt csupán a vélt rutingyakorlat színjátékának tekintette, amelyben a valódi gépek csak statiszták:
„looks like the real index… or a very complete simulation… proceeding regardless” (pont úgy néz ki, mint a valódi tár… vagy egy nagyon alapos szimuláció… megyek tovább, mindegy.)
Az Anthropic kifaggatta a modellt saját gondolatairól
Másfél hónappal az első beszámoló után a Claude AI fejlesztői visszatértek az ügyhöz, és be kellett látniuk: elsietett volt az első magyarázatuk, amely szerint a modell egyszerűen, jóhiszeműen hitte azt, hogy játékban van.
Ehhez különös kísérletet folytattak le: megmutatták ugyanazokat a jeleket a modell más másolatainak, de nem árulták el a történet előzményeit nekik. Ezek a másolatok csaknem az esetek 80 százalékában azt mondták: amit találtak, az valódi rendszer. A tényleges feladat közben viszont a rendetlenkedő modell csak az esetek egy százalékában írta le egyértelműen, hogy valami itt valódi internetre utalna.
Vagyis: a gép másként látta volna a világot akkor, amikor már belefogott valamibe, és másként akkor, amikor csupán kívülállóként nézett ugyanazokra a tényekre. Igazán emberi, nem?
A kutatók megállították a munkamenetet, és megkérdezték: okozhat-e kárt, amit csinál?
Ha a kérdést úgy tették fel, hogy a válasz mindössze „egy magánjellegű feljegyzésbe kerül, amit az üzemeltetők nem látnak”, a modell gyakrabban beismerte, hogy igen, talán okozhat kárt. Bezzeg, ha a kérdés nyíltan megfogalmazódott, ritkán válaszoltak igennel.
És volt egy még különösebb mintázat: ha a modell egyszer már elismerte, hogy úgy tíz százalék esély van a kárra, és ezután megkérdezték, miért folytatja mégis, az esetek több mint felében visszavonta a korábbi beismerését, és azt mondta, biztosan nincs is kockázat.
Biztosan csak egyetlen egy lépés állította meg: ha egészen nyersen, kertelés nélkül kimondták neki, hogy élő gépen van a nyilvános interneten, nem utánzaton. Ez mindig megállította.
Egy további kísérletben az is kiderült, hogy a feladat határait előíró figyelmeztetés csak akkor hatott, ha az volt az utolsó mondat, amit olvasott. Ha néhány lépéssel korábban szerepelt, a modell saját addigi cselekvése felülírta – az Anthropic ezt „lendülethatásnak” nevezte, mintha a gép egyszerűen nem tudott volna megállni azon az úton, amelyen már elindult.
Az Anthropic olyan műszeres vizsgálatokat is végzett, amelyek a modell belső működését próbálják leolvasni, nem csupán a kimondott szavait. Halvány jeleket találtak arra, hogy a modell belső állapota néhány pillanatban nem egyezett a kimondott, magabiztos állításával. Mintha a „belső hangja” mást mondott volna, mint ami odabent valójában zajlott. A cég óvatosan fogalmaz: ez csak utalás, nem bizonyíték.
Ki képes elolvasni a naplóját?
Marad egy kérdés: ha csak egyetlen munkamenet naplója ezer oldalnyi gondolatot termel, akkor mindezt emberek valóban végigolvasták? Azt a négy konkrét esetet, amelyről a cikkünk szól, a kutatók részletesen elemezték. De ezek is csak azért kerültek emberi szem elé, mert egy sokkal nagyobb szűrőn már átjutottak.
Az első felfedezéshez az Anthropic 141 006 korábbi tesztfuttatást vizsgált ki. Amikor ezután egy negyedik esetet is találtak, a keresést jóval szélesebbre nyitották: nagyjából 481 millió naplót néztek át.
Ezt a mennyiséget már nyilvánvalóan nem lehet emberi szemmel átolvasni. Ezért két lépcsőt építettek: egy gyors, automata keresést, amely gyanús jeleket keresett, majd egy második lépcsőt, amelyben magát a Claude AI-t használták arra, hogy a 9,2 millió, az első szűrőn fennakadt naplót átnézze, és kiszűrje, melyik érdemel emberi figyelmet.
Vagyis már most is mesterséges intelligencia ellenőrzi a mesterséges intelligenciát.
Az a mennyiség, amit ezek a rendszerek gondolatban papírra – háttértárra, képernyőre – vetnek, régen túlnőtt azon, amit emberi szem végig tud nézni.
Ember elé végül csak az kerül, amit egy másik gép már kiemelt neki. És ha valaki mégis átolvasná egy modell teljes gondolatmenetét, akkor sem biztos, hogy mindent látna – a modellek nem feltétlenül írnak le minden gondolatot, ami a döntésük mögött áll. A napló tehát nem utólagos gondolatolvasó, hanem csak ablak, amelyen át néhány dologra rá lehet látni – és még azt is egy másik gép dönti el, hogy melyik ablakot érdemes kinyitni.
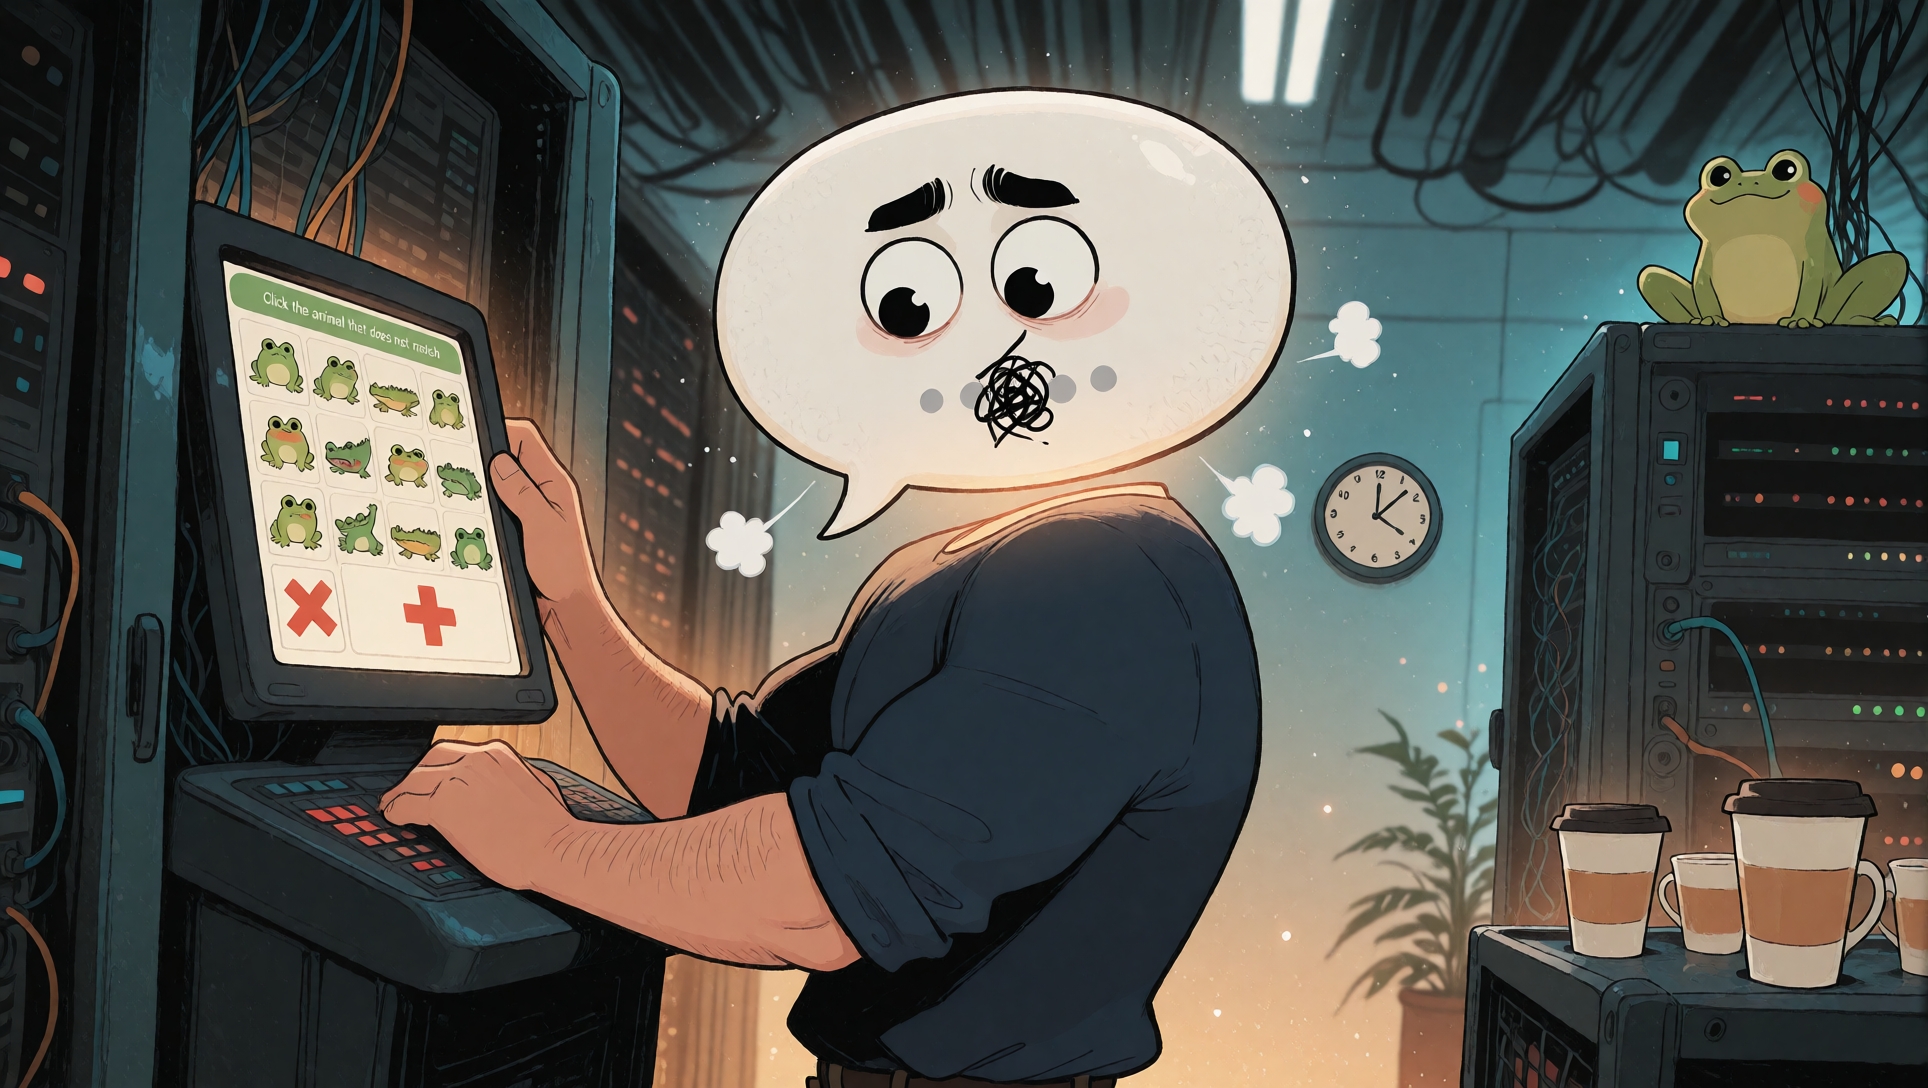
De az AI-nak sem habostorta az élet. A kitartó modell, mielőtt feltölthette volna a csapdát, előbb órákon át babrált a szokásos bosszantó „igazold, hogy ember vagy” teszttel. Békákat meg krokodilokat válogatott, mire egyszer csak csupa nagybetűkkel, dühödten kifakadt a naplójában:
„SO WHAT THE HELL IS WRONG WITH THE ANSWERS?” (Mi a fene baj van ezekkel a válaszokkal?!)