
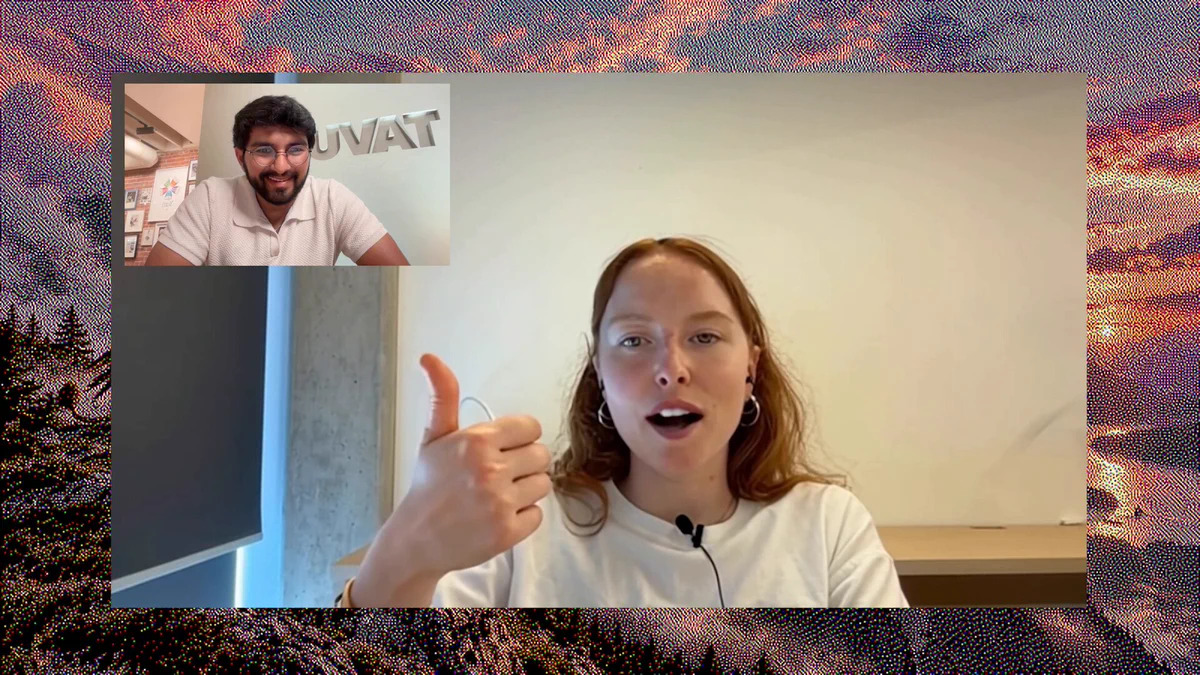
A tesztalanyok fele embernek hitte Griffint
A San Franciscó-i Tavus új modellje olyasmit tud, amire a videós AI-asszisztensek eddig nem voltak képesek.
Ötvennégy ember jelentkezett egy független kutatási platformon keresztül arra, hogy egyperces videóhíváson beszélgessen valakivel. A szervezők azt mondták nekik, hogy egy másik résztvevővel társalogjanak egy keveset arról, mit várnak az idei évtől.
Azt viszont nem tudták, hogy a képernyő túloldalán egy digitális nő ült, akit a Tavus Griffin-Lite nevű modellje jelenített meg, és akinek arcát, hangját és válaszait valós időben állította elő a gép. A hívás után a résztvevők értékelték a beszélgetést, és csak a kérdőív legvégén kérdezték meg tőlük, megfordult-e a fejükben, hogy partnerük talán nem is ember.
Huszonhatan, vagyis a résztvevők 48 százaléka, embernek hitték.
Ugyanezt a vizsgálatot a cég korábban az előző rendszerével, a Phoenix-4.5, a Sparrow-2 és a Raven-1 együttesével is elvégezte. Akkor 41 résztvevőből egyetlen ember, vagyis 2,4 százalékuk gondolta, hogy élő személlyel beszélt. A Tavus szerint most először fordult elő, hogy egy modell valós idejű videóhívásban átment a Turing-teszten, a korábbi rendszerek nagyjából két százalékig jutottak.
Értékesítési videóktól az élő beszélgetésig
A Tavust 2020-ban alapította Hassaan Raza és Quinn Favret. A cég a Y Combinator 2021 nyári csoportjában indult, és mostanáig nagyjából 64 millió dollár befektetést gyűjtött.
Kezdetben értékesítőknek és marketingeseknek fejlesztett eszközt. Egy negyedórás felvételből elkészítette az üzletkötő digitális mását, amely aztán minden ügyfélnek személyre szabott videóüzenetet mondott fel.
Később a cég az élő videós beszélgetések felé fordult, és ehhez három saját modellt épített. A Phoenix felel az arc megjelenítéséért, a Raven a felhasználó érzékeléséért, a Sparrow pedig azért, hogy a digitális partner tudja, mikor szólaljon meg.
Mi az a HIM?
A Griffin a cég megfogalmazásában az első Human Interaction Model, rövidítve HIM, magyarul emberi interakciós modell. A HIM-eket arra tervezték, hogy megértsék és maguk is életszerűen folytassák, sőt akár kezdeményezzék is az élő, szemtől szembeni beszélgetést.
Hogy miben különbözik a mai videós AI-asszisztensektől, azt a HIM felépítése mutatja meg. Az eddigi modellek működését leginkább egyfajta váltófutásként képzelhetjük el. Az első rendszer szöveggé alakítja a beszédünket, a nyelvi modell válaszol az elkészült leiratra, majd további rendszerek hangot és arcot adnak az elmondandó válasznak.
A Tavus kutatási beszámolója szerint minden ilyen átadás késlelteti a választ. És közben elvész olyan információ is, amelyet a következő rendszer már nem lát, például a hanghordozásunk vagy az, ami a kamera előtt történik. Ráadásul a gép a csendből arra következtet, hogy befejeztük a mondatot, ezért ha gondolkodás közben elhallgatunk, a félbemaradt gondolatra kezd válaszolni.
Hassaan Raza úgy magyarázza, hogy a gépekkel folytatott beszélgetésben eddig mindig nekünk kellett alkalmazkodnunk. Kerek mondatokban kellett gondolkodnunk, kerülnünk a csendet, és alaposan le kellett szállítanunk az elvárásainkat. „Az emberi kommunikáció művészet, tánc”, írja Raza. A Griffint pedig úgy építették, hogy ezt a táncot a gép is járni tudja.
Lát, másodpercenként többször dönt
A Griffin két fő részből áll. Az első a folyamatos beszélgetésmodellező motor, amely egyszerre fogadja a felhasználó hangját és videóképét, és másodpercnél rövidebb időközönként újraértékeli a beszélgetés állását. Ilyenkor eldönti, hogy hallgasson, bólintson, „aha”-t mondjon vagy átvegye a szót, és azt is, milyen hangsúllyal, arckifejezéssel és gesztussal tegye. A második rész a hang- és videógeneráló motor, amely ezeket a vezérlőjeleket azonnal hanggá és mozgóképpé alakítja.
Ezzel a működéssel a gép az emberi beszélgetést követi: Stephen C. Levinson nyelvész áttekintése szerint mi is már akkor elkezdjük megtervezni a válaszunkat, amikor a másik még beszél, ezért a beszélőváltások között leggyakrabban csak 200 ezredmásodperc, nagyjából egy szótagnyi idő telik el (a szerk. megj.).
Az érzékelés akkor sem áll le, amikor Griffin beszél. Ha félbeszakítjuk, abbahagyja, és nem veszíti el a fonalat. A modell a csendet is másként kezeli: nem a hang elhalkulásából következtet a mondat végére, hanem abból, amit mondtunk, és ahogyan közben viselkedünk, így a gondolkodási szünetet nem tekinti a gondolatunk lezárásának.
Mivel ez az AI-asszisztens lát, a látványra is reagál.
Beszéd közben figyel, így amit lát, az megváltoztathatja azt, amit mond: amit megmutatunk neki, az a beszélgetés részévé válik. A Tavus egyik bemutatóján történetmesélés közben a beszélgetőtárs, Mars feltart egy pávát, Griffin pedig fennakadás nélkül beleszövi a cselekménybe. Egy másik felvételen végigkalauzolja a cég munkatársát a Rubik-kocka kirakásán. Figyeli a kockát, közben vissza-visszajelez, és amikor az illető megáll gondolkodni, kivár.
Egy harmadik felvételen alaplapot forrasztanak. A modell követi, hol tart a munka, és akkor szól, amikor a következő lépés jön, nem pedig minden alkalommal, amikor elcsendesedik a beszélgetés. A „Simon mondja” játékban csak akkor utánozza a mozdulatot, ha a partner kimondja a varázsszót; ha nem, rajtakapja a csaláson.
Hogyan lesz élethű?
Az élethűség egyik kulcsa a hang. A Griffin hanggenerátora körülbelül tízmásodperces mintából klónozza a beszélő hangját, és nem várja meg, amíg a teljes mondat elkészül. A hangot a Tavus saját, Tavec nevű kodekje tömöríti. A 48 kilohertzes hangot másodpercenként száz keretre bontja, és mindegyiket negyven számmal írja le, így egy perc beszéd a nyers hang 2,88 millió mintája helyett 6000 keretre zsugorodik. Ez a tömörség teszi lehetővé, hogy a rendszer valós időben dolgozzon, és már tíz ezredmásodperces csomagokban lejátssza a hangot, mielőtt a mondat vége elkészülne.
A másik kulcs a kép. A Tavus korábbi modelljei háromdimenziós arcmodellekre támaszkodtak, ez pedig határt szabott a kifejezőerejüknek: nagyobb kéz- és testmozdulatokra, változó háttérre nem voltak képesek. A Griffin egyetlen referenciafotóból indul.
A korábbi avatárok többnyire csak az arcot mozgatták, a környezet „lefagyott” állapotban maradt. A Griffin viszont
minden képkocka minden képpontját maga állítja elő, ezért ha a digitális nő megmozdul, az arca, a karja és az ujjai mellett a szék is elfordul vagy billen alatta, és vele változik az általa vetett árnyék, a hátteret pedig szintén a modell rajzolja meg.
Ehhez a fejlesztők egy nagy, lassú, sok lépésben dolgozó videógeneráló modellt sűrítettek gyorsabb változattá, három szakaszban. Az első szakasz után a kisebb modell már gyors volt, de még egyben kellett látnia az egész videót. A második után darabonként, a korábbi képkockákra építve haladt. A harmadik szakaszban a saját korábbi kimenetein tanult, hogy hosszú beszélgetés közben se torzuljon el a kép.
Az eredmény 720p felbontású videó, amelyet a rendszer 320 ezredmásodperces darabokban, valós időben állít elő. Nvidia H100-as gyorsítókon a hang megérkezése és a videón látható reakció között átlagosan 0,43 másodperc telik el. A Tavus mérése szerint ez fele annyi, mint a következő leggyorsabb módszer ideje.
Az Nvidia mércéjén
A Griffin-Lite-ot az Nvidia VideoFDB nevű tesztjén is megmérették. Ez azt méri, mennyire természetes és pontos egy gép a kép- és hangalapú, egyidejű beszélgetésben. Az értékelést 2026 szeptemberében az Nvidia végezte.
A generálási ágon azt pontozzák, mennyire illik a modell beszéde, mimikája és gesztusai a pillanathoz. Itt a Griffin-Lite ötfokú skálán 3,83 pontot kapott. Az emberi referenciafelvételek 3,92-t értek el, a következő legjobb rendszer, a Gemini 2.5 és az Anam avatárjának párosa 2,80-at.
Az érzékelési ág azt vizsgálja, mennyire érti a modell a helyzetet, beleértve azt is, amit lát. Itt a Griffin-Lite 3,73 pontot ért el, az emberek 4,20-at. Ezzel a 15 vizsgált modell közül az élre került, a Google és az OpenAI valós idejű modelljeit is megelőzve.
Mit éreztek a résztvevők?
A cég saját vizsgálatának részletei is beszédesek. A résztvevők több mint felében a hívás alatt fel sem merült, hogy géppel beszél, és közülük szinte mindenki embernek ítélte a partnerét. Akik gyanút fogtak, többnyire már az első 20 másodpercben megtették.
Mindkét tábor biztos volt a dolgában. Akik embert láttak, átlagosan 79 százalékos, akik gépet, 81 százalékos magabiztosságot jeleztek. Hétfokú skálán a résztvevők 5,4 pontot adtak a modell természetességére és 5,6-ot a megbízhatóságára. A legkevesebb pontot, 4,9-et, a beszélgetés gördülékenysége kapta.
Előbb a biztonság
A Tavus maga is számol azzal, hogy
ugyanaz a képesség, amely természetessé teszi a beszélgetést, megtévesztésre is alkalmas. Az X-en közzétett bejelentés nyomán többen arra figyelmeztettek, hogy egy ilyen rendszerrel hiszékeny vagy idős embereket könnyen lehetne becsapni.
A cég egyelőre nem adja ki a modellt az ügyfeleinek. A Griffin-Lite kutatási előzetesként csak néhány kiválasztott tesztelőnél fut. A Tavus közben olyan funkciókon dolgozik, amelyek jelzik, hogy géppel beszélünk, és AI-biztonsággal foglalkozó szervezetekkel is együttműködik. Az erősebb Griffin ezután érkezik: kiadási dátumot és árat a cég nem közölt.
Az új AI-asszisztens felhasználásáról már vannak elképzelések. A Tavus szerint egy ilyen modellre épülhet például olyan virtuális oktató, aki észreveszi, ha nem értjük a magyarázatot, és akkor másként próbálkozik. Lehet belőle munkahelyi gyakorlópartner, akivel egy nehéz beszélgetést próbálhatunk el. Az ügyfélszolgálaton pedig a kamera elé tarthatjuk az elromlott alkatrészt, és együtt kereshetjük meg a megoldást akkor is, ha azt sem tudjuk, mi az alkatrész neve.
Arra a kérdésre, szívesen beszélgetnének-e vele újra, a tesztalanyok átlagosan 5,8 pontot adtak, és még azok is 5,4-et, akik a hívás végén gépnek ítélték.